XML과 친해지기
XML이란
데이터를 저장하고 전달하는 문서와 같다. XML을 통해 데이터 구조를 언어로 쉽게 기술할 수 있다.
- 새로운 태그를 만들 수 있다.
- 데이터를 보여주는 것이 아닌, 전달 및 저장을 주목적으로 한다.
- 유니코드 문자로만 구성되어있다.
(+) SGML / HTML / XML / SVG / XHTML 등의 개념 층위?
왜 XML인가?
데이터를 교환화는 과정에서 호환되지 않는 데이터 타입으로 인한 충돌, 변환 과정에서의 왜곡 및 손실 등이 발생한다. XML은 “텍스트”의 통일된 형태이므로 데이터의 저장 및 전달에 유용하다. (운영체제, 프로그램 등의 종류로부터 자유롭기 때문)
기타 이점 참고: https://velog.io/@dbekdms17/파싱
XML의 구성
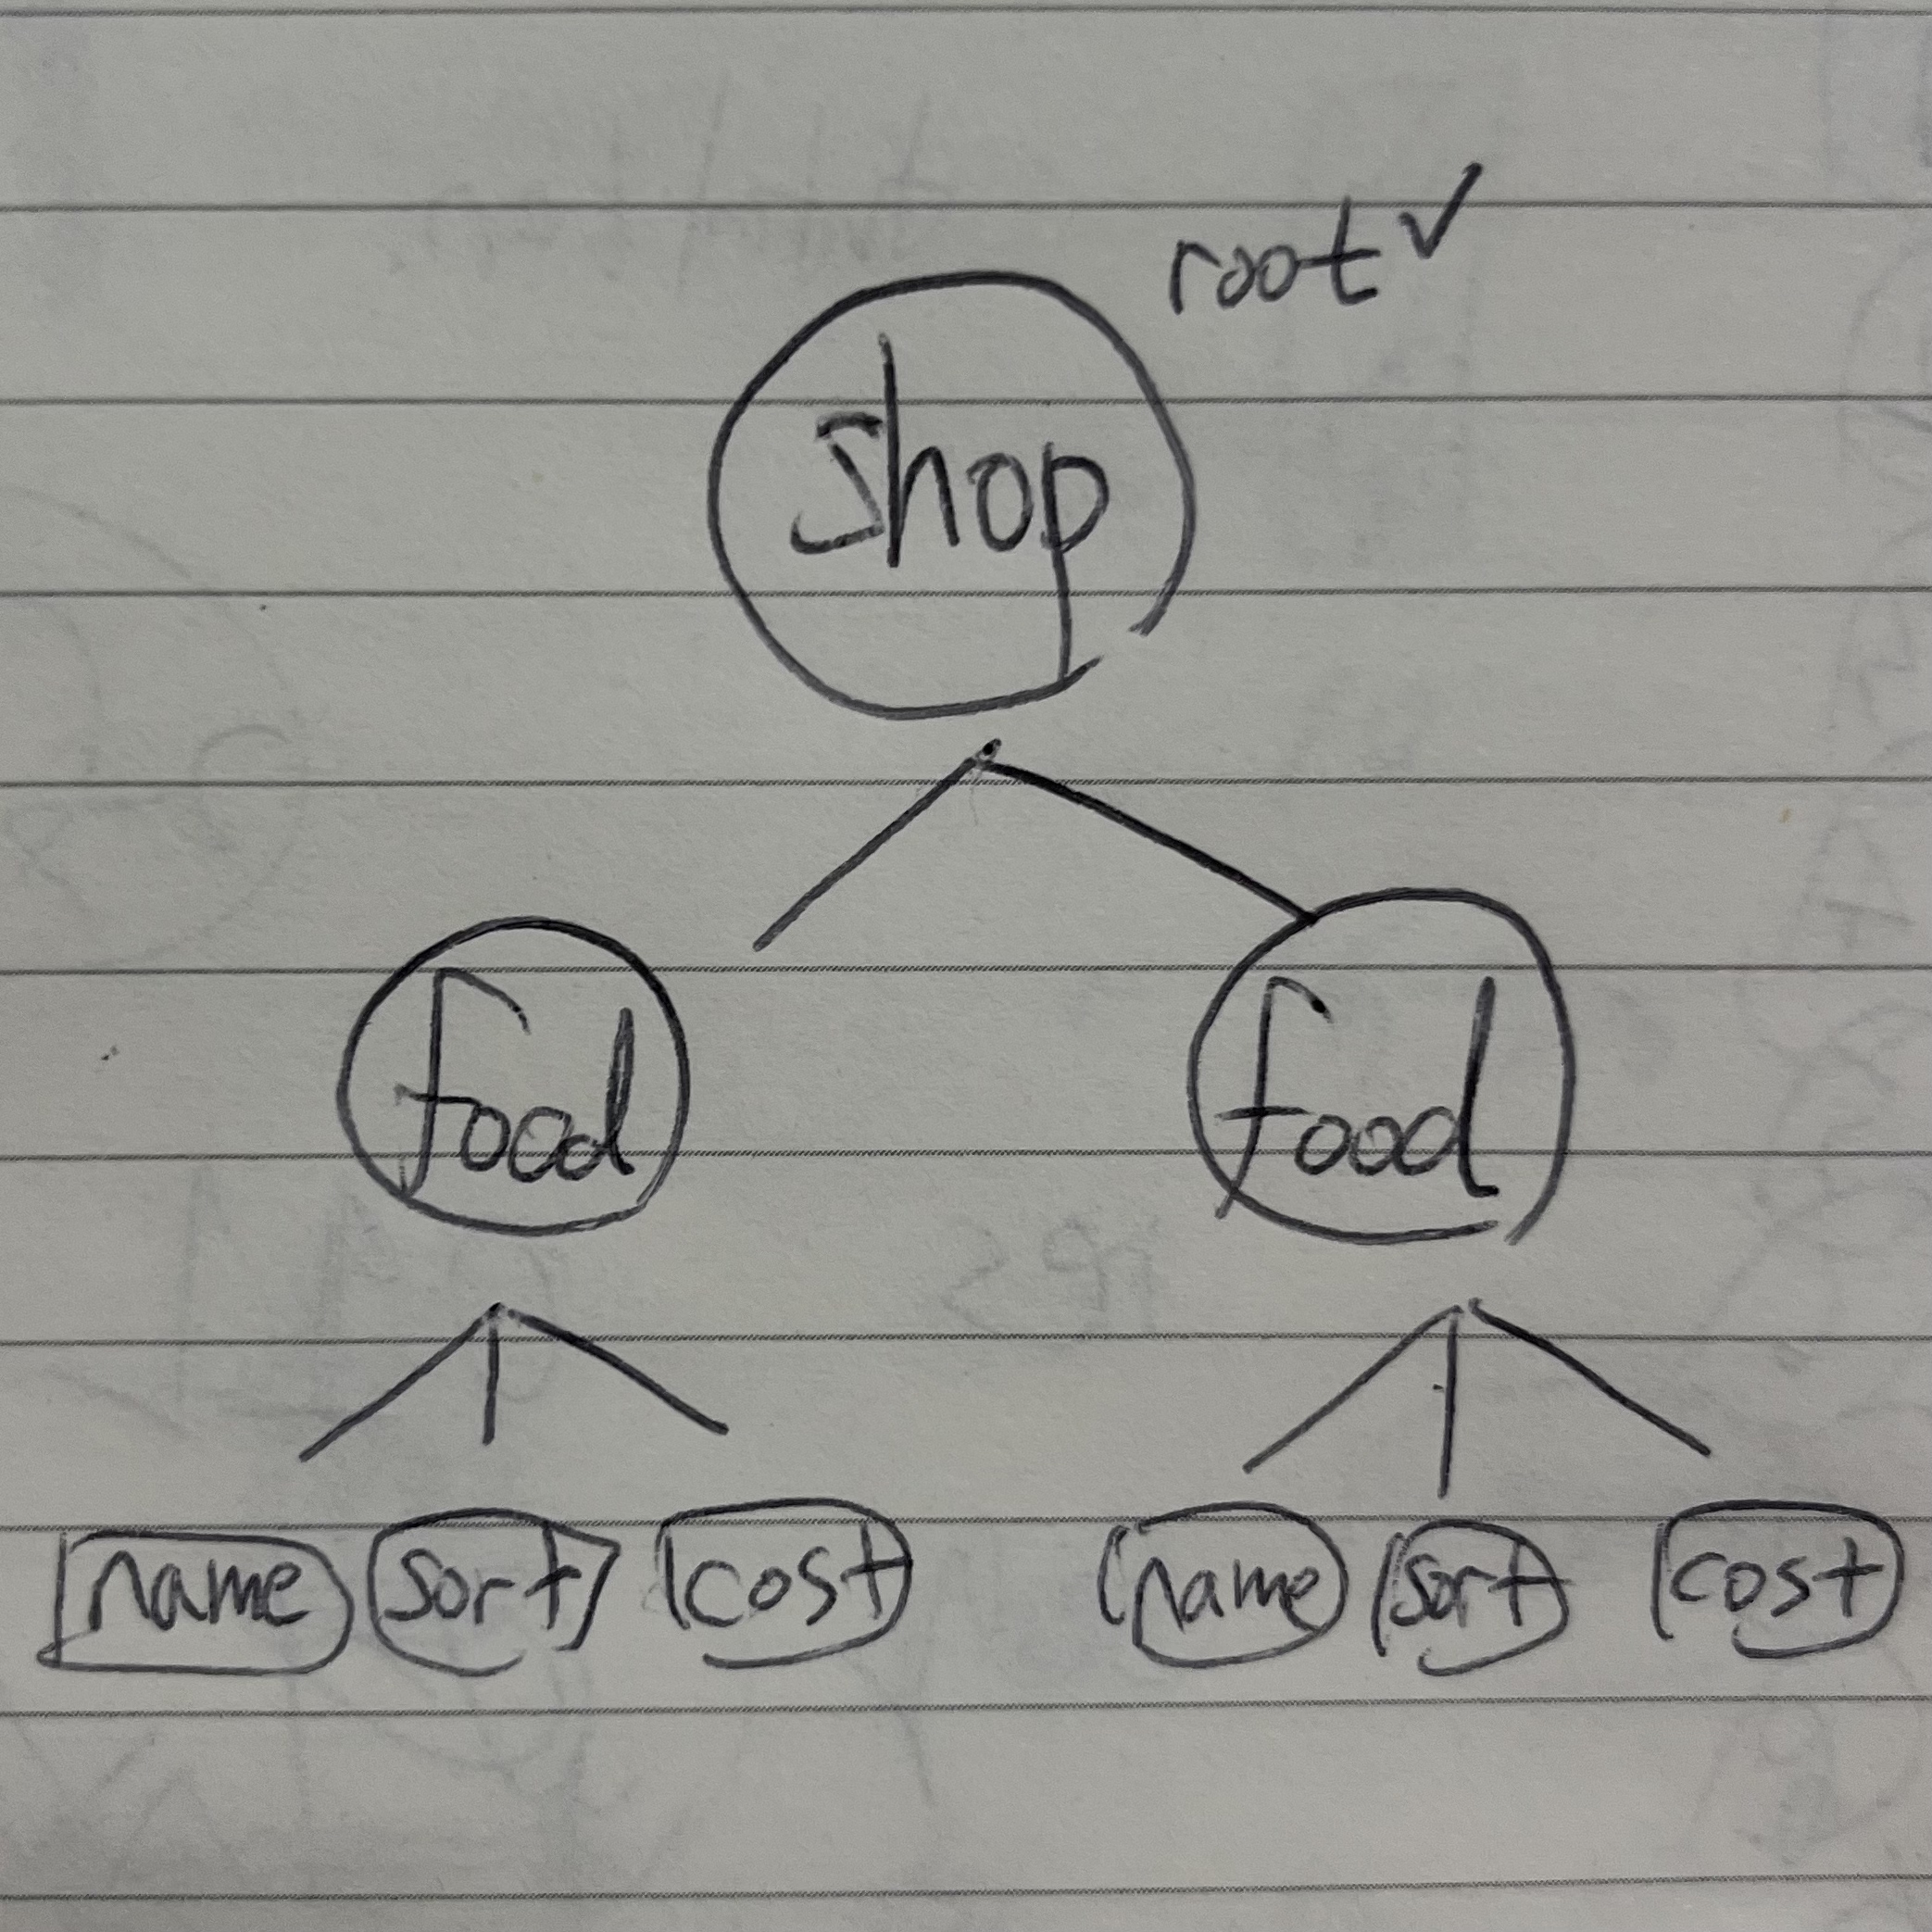
- 트리 형태의 계층 구조를 갖는다. 최상위에 유일한 root요소와, 이후 부모-자식 관계로 연결되어있는 요소들로 이루어져 있다.
- 하나의 부모는 여러 개의 자식을 가질 수 있지만, 하나의 자식이 여러 개의 부모를 가질 수는 없다.
- 모든 요소가 자식을 가질 수 있다.
- 모든 요소가 텍스트와 속성을 가질 수 있다.
XML의 문서 구조
xml 태그를 통해 문서 형식을 명시한다.
1
<?xml version="1.0" encoding="UTF-8"?>
xml 태그 직후의 요소는 root를 의미한다. 아래의 예제에서는 shop태그에 해당한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
<shop city="서울" type="마트">

    <food>

        <name>귤</name>

        <sort>과일</sort>

        <cost>3000</cost>

    </food>

    <food>

        <name>상추</name>

        <sort>야채</sort>

        <cost>2000</cost>

    </food>

</shop>
위의 예제를 간단한 트리 형태로 추상화해보자. 형제와 부모 관계가 더욱 명확해진다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
[
  '<shop city="서울" type="마트">',
  '<food>',
  '<name>',
  '</name>',
  '<sort>',V
  '</sort>',
  '<cost sale="true">',
  '</cost>',
  '</food>',
  '<food>',
  '<name>',
  '</name>',
  '<sort>',
  '</sort>',
  '<cost>',
  '</cost>',
  '</food>',
  '</shop>'
]
XML의 세부 문법
XML 문서를 명시하는 XML 프롤로그가 있다.
- version: XML의 문서버전이다. (마지막 버전은 1.1) 필수
- encoding: 문자셋을 명시한다. (기본값은 UTF-8) 옵션
- standalone: 외부 소스의 데이터에 의존하고 있지 않은지의 여부다. (기본값은 no다) 옵션 yes면 외부 소스 참고할 필요가 없는 것
1
<?xml version="XML문서버전" encoding="문자셋" standalone="yes|no"?>
XML 규칙 (요구사항에 명시된 스펙과 함께 정리 *)
주석
✅ !으로 시작하면 주석으로 인식하여 저장하지 않는다
(+) 주석 내용 안에 두 개의 연속된 하이픈-이 존재하면 오류로 인식한다.
(+) 중첩하여 주석을 작성할 수 없다.
엘리먼트
시작태그부터 종료 태그까지의 모든 것을 의미한다.
✅ 모든 요소는 종료 태그를 가진다. (이외의 경우는 오류다.)
빈 태그도 반드시 슬래시를 통한 self-closing을 해야 한다. ✅ 대소문자를 구분한다. 따라서, 시작 종료 태그의 대소문자까지 일치해야 한다.
✅ 태그의 여닫는 순서가 반드시 지켜져야 한다.
✅ 속성은 반드시 따옴표로 감싸야 한다.
✅ 태그 내부 텍스트의 띄어쓰기를 인식한다.
- 지원하는 XML 태그 스펙
- 도입부 Prolog :
<?xml>처럼 앞이?로 시작하면 XML에 대한 정보. 내부에 저장할 때는 prolog 항목에 저장한다. - 주석 Comment :
<!DOCTYPE>처럼 앞에!로 시작하면 XML 주석으로 처리하고 저장하지 않는다. - 요소 Element :
<HTML>또는<plist>처럼<바로 다음에 나오는 한 단어는 요소 element로 처리한다.- 모든 요소는 시작 태그로 시작해서 종료 태그로 끝난다.
<HTML> ... </HTML> - 시작 태그와 종료 태그 사이에는 값 Value 또는 다른 태그를 중첩해서 포함할 수 있다. ▪
<P>Hello</P>▪<P><IMG SRC="camp.jpg">camp</IMG></P> - 값이 없어도 되는 특정한 태그들은
</br>형태로 시작-종료 태그를 한꺼번에 표시한다. - 시작 태그
>좌측 부분에는 해당 태그의 속성을 명시할 수 있다.<FONT name="Newyork">Big Apple</FONT>
- 모든 요소는 시작 태그로 시작해서 종료 태그로 끝난다.
- 도입부 Prolog :
[엘리먼트 명명 규칙]
- 영문, 숫자, 하이픈, 언더스코어, 점만으로 구성
- 대소문자 구분
- 영문자나 언더스코어로만 시작
- 공백 포함 불가능
- xml, XML, Xml 등의 예약어 불가능
(* 중복된 이름은 네임스페이스를 통해 충돌을 방지한다: https://www.tcpschool.com/xml/xml_basic_namespace)
속성
- 속성은 여러 개의 값을 가질 수 없다
- 속성 자체는 여러 개일 수 있으나, 공백으로 분리한다.
- 중복된 속성명을 사용할 수 없다
- 값은 반드시 가지지만, 빈문자열도 가능하다.
- XML 트리에 포함되지 않는다
엔티티
다섯 개의 특별한 기호는 XML 파서에서 완전히 다르게 인식한다. 엔티티는 이렇게 다르게 인식하는 것을 방지하고 있는 그대로의 의미를 유지하기 위한 문자셋이다.
| 호 | 엔티티 이름 | 16진수 엔티티 | 설명 |
|---|---|---|---|
| < | < | < | 보다 작은 |
| > | > | > | 보다 큰 |
| & | & | & | and 기호 |
| ” | " | " | 큰따옴표 |
| ’ | ' | ' | 작은따옴표 |
(https://www.tcpschool.com/xml/xml_basic_syntax)
위의 5가지는 내장된 엔티티고, 이것 외에도 일반/문장/외부/파라미터 엔티티 등의 종류가 더 있다 OMG (참고: https://blog.naver.com/taekani/130015663753)
XML 파서 Parser
XML 파서란
응용 프로그램이 XML 문서를 읽을 수 있도록 인터페이스를 제공한다. 형태의 적합성과 문법상의 오류까지 확인한다.
동작 방식은 아래와 같다.
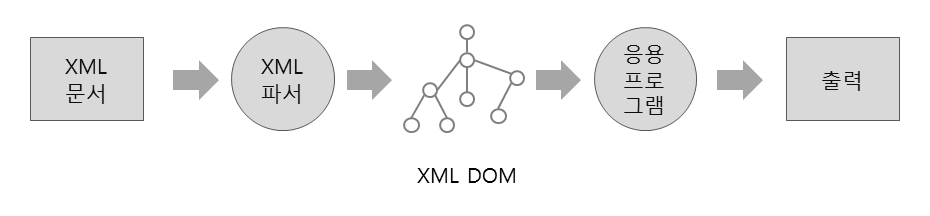
XML 문서를 plain text 자체로 읽고 → XML DOM 객체로 반환한다. 미션에서 트리 형태로 저장하는 것과 유사하다.
DOM에 대해서
DOM은 이미 HTML문서를 다루면서도 익히 들어봤듯이, 문서의 요소와 각 요소에 대한 접근 방법까지 정의한다. 위의 XML DOM도 이에 해당.