웹에서 이미지를 표현하는 방식에 대해
웹에서 이미지를 표현하는 방식에 대해
왜 공부해야 할까
통계분석 소프트웨어를 개발하면서 무언가를 시각화하는 일이 많아졌다. 분석 결과를 다양한 테이블과 플롯으로 표현해야 했고, 사용자가 직접 다운로드 하거나 서버에 영구 저장할 수 있는 형태로 변환해야 하는 일도 많았다.
개발되어 있는 api를 그대로 사용하며 연동하는 일은 어렵지 않았으나 문득 이미지가 어떤 데이터 형태로 관리되는지 해상도가 높지 않은 상태에서 개발하는 것이 두려워졌다. 특히 미리캔버스에서 디자인 에디터를 개발하던 시절에, 핵심 편집 요소인 이미지에 대해서 딥다이브 하지 못했다는 부끄러움도 있었다.
기본적으로 이번 기회를 통해서는 이미지와 관련하여 웹 api로 기본적으로 제공되고 있는 기능들을 학습할 것이다. 또한, ai와 함께 학습하면 좋을 필수 요소들을 아래와 같이 구성해보았다. (thanks … claude..)
웹에서 이미지 데이터를 표현하는 방법들
- Base64 인코딩: 문자열로 변환된 이미지 데이터
- Blob: 바이너리 이미지 데이터
- Object URL (
createObjectURL): 메모리 상의 이미지 참조 - Data URL:
data:image/png;base64,...형식
핵심 키워드
base64, Blob, createObjectURL, revokeObjectURL, Data URL, Canvas.toBlob(), Canvas.toDataURL(), FileReader, Response.blob(), download attribute
웹에서 이미지 데이터를 표현하는 방법들
Base64 인코딩: 문자열로 변환된 이미지 데이터
일단 나의 교과서인 Mdn 문서를 따라가보자.
(1)
Base64는 이진 데이터를 기수-64 표현으로 변환하여 ASCII 문자열 형식으로 나타내는 유사한 이진 데이터를 텍스트로 인코딩방식의 그룹입니다. ‘Base64’라는 용어는 특정 MIME 콘텐츠 전송 인코딩에서 생겼습니다.
인코딩이란, 사람의 눈으로 보는 !, ?, 1 등의 문자를 컴퓨터가 이해할 수 있는 (디지털)형태로 변환하는 규칙을 말한다. 이렇게 같은 규칙을 사용해야만 특정 문자들을 정의하거나, 해석할 때 깨지지 않고 양방향으로 정확하게 전달할 수 있을 것이다.
ASCII 문자열 형식은 인코딩 방식 중 초기에 등장한 대표적인 방식이다. 현재 더 익숙하고 널리 알려진 방식은 UTF-8로, ASCII보다 더 많은 문자열을 효율적으로 표현할 수 있다. (*)
Base64는 “이진데이터”를 → “기수-64표현”으로 변환하는 인코딩 방식의 그룹이라고 한다. (우리가 사용하는 모든 파일(이미지, 영상, 프로그램 실행파일 등)은 근본적으로 이진 데이터일 것이다.)
이미 컴퓨터에서 잘 해석할 수 있는 이진 데이터임에도 불구하고, 왜 Base64라는 새로운 인코딩 방식이 필요했을까?
(1) ASCII 문자만 허용하는 레거시 시스템에서 모든 종류의 데이터를 전송하기 위해
예를 들어, 원래의 SMTP(이메일 프로토콜)에서는 ASCII 128문자만 허용했지만, 이미지를 첨부하거나 비영어권 문자 등의 다양한 데이터를 주고받을 수 있어야 했다. 이런 상황 속에서 Base64는 모든 바이너리 데이터를 안전한 ASCII 표현 범위로 변환하여 전송할 수 있게 해주었다.
(2) 7비트/8비트 시스템 간 호환성
과거 일부 시스템은 7비트 바이트를 사용했지만, 현대 시스템은 8비트를 사용한다. Base64는 ASCII문자를 생성하므로 (ASCII 문자는 7비트 형식), 8비트 데이터를, ‘7비트만 인식하는 환경’에서도 안전하게 사용될 수 있도록 변환해준다.
(3) 특수문자의 의미 충돌 방지
모든 텍스트 기반의 시스템(SMTP 등의 이메일 프로토콜, URL)에서는 자체적인 명령어와 구분 기호가 있다. 예를 들어, “@”은 이메일 프로토콜에서 사용자 이름과 도메인을 구분해주며, “&”은 HTTP Url에서 여러 개의 쿼리 매개변수를 분리하는 역할을 해준다. “You&I”와 같은 문장에서 순수하게 문자로 쓰인 “&”도 시스템에 따라 다르게 해석될 수 있는 것이다.
만약 이진 데이터가 특정 인코딩 방식 없이 텍스트 그대로 전송된다면, 이미지 데이터에서 0과 1의 일부분의 조합이 “@”나 “&”와 같은 값으로 우연히 나타날 수 있다. 원래 데이터 의도와는 다르게 데이터가 손실되거나 변형될 수 있는 위험이 발생한다. (Base64인코딩 방식은 이러한 문제를 오직 64개의 안전한 순수 텍스트 문자로 변환하여 해결한다.)
어떤 문제를 해결하고자 등장한 인코딩 방식인지 대충 개념을 이해할 수 있었다. 찝찝한 것은 “…인코딩 방식의 그룹입니다”라는 표현이다. 그냥 인코딩 방식도 아니고, 인코딩 방식의 “그룹”이라는 것은 무슨 의미일까?
→ 하나의 엄격한 표준이 있는 것이 아니라, 기본 원리를 기반으로 사용 환경에 따라 문자를 조금씩 다르게 사용하는 여러 규칙들의 집합을 의미하기 때문이다. 즉, “이진 데이터를 64개(알파멧 대소문자 52개, 숫자 10개)의 안전한 문자로 변환해요”라는 핵심 규칙은 공유하지만, 거기에 사용되는 문자가 조금씩 달라질 수 있다.
기본적인 base64는 나머지 2개의 추가 문자로 +와 /를 사용하지만, Base64 URL 방식에서는 추가 문자를 -와 _를 사용한다. /가 경로를 구분하는 기호로써 다르게 해석될 수 있기 때문이다.
() Base64 용어가 MIME 콘텐츠 전송 인코딩 규약에서 정의되었다고요?*
MIME은 Multipurpose Internet Mail Extensions의 약자로, (위에서 살펴보았던 Base64 등장의 이유와 마찬가지로) 7비트 ASCII를 넘어서는 복잡한 이진 데이터를 포함하여 안전하게 전송하기 위해 표준 규칙을 확장한 것이다.
데이터를 전달할 때, 데이터의 종류와 인코딩 방식을 수신 측에 알려준다.
Content-Type 헤더를 통해 데이터의 종류를, Content-Transfer-Encoding을 통해 어떤 인코딩 방식을 사용했는지 표시한다. 이때 Base64도 Content-Transfer-Encoding 방식 중 하나로 정의되었다는 것!
(2)
Base64 인코딩 체계는 일반적으로 ASCII 텍스트만 처리할 수 있는 미디어(또는 여전히 임의의 이진 데이터를 수용하기에 부족한 일부 ASCII 상위 집합)를 통해 저장하거나 전송하기 위해 이진 데이터를 인코딩하는 데 사용됩니다. 이렇게 하면 전송 중에 데이터가 수정되지 않고 그대로 유지됩니다. Base64의 일반적인 애플리케이션은 다음과 같습니다.
Base64가 필요한 이유에 대한 서술인데, 위의 등장배경에서 이미 살펴본 내용이므로 넘어가도록 하겠다.
(3)
각 Base64 숫자는 6비트의 데이터를 나타냅니다. 따라서, 입력 문자열/이진 파일의 8-비트 바이트 3개(3x8비트 = 24비트)는 6비트 Base64 숫자 4개(4x6 = 24비트)로 표현될 수 있습니다.
이는 문자열이나 파일의 Base64 버전이 일반적으로 원본 대비 3분의1 만큼 더 크다는 것을 의미합니다(정확한 크기 증가는 문자열의 절대 길이, 길이를 3으로 나눈 나머지 값, 패딩 문자 사용 여부 등 다양한 요인에 따라 달라집니다).
원본 이진 데이터 바이트 3개 → Base64의 숫자 4개로 표현되므로, 인코딩되었을 때 크기가 증가한다. 남은 원본 이진 데이터가 3의 배수가 아니면 어떡할까? 이때 남은 1 또는 2바이트를 패딩문자(ex. =)를 활용하여 변환이 끝났음을 알릴 수 있다.
토스의 개발자 센터의 인코딩 과정 설명을 통해 더 쉽게 이해할 수 있다.
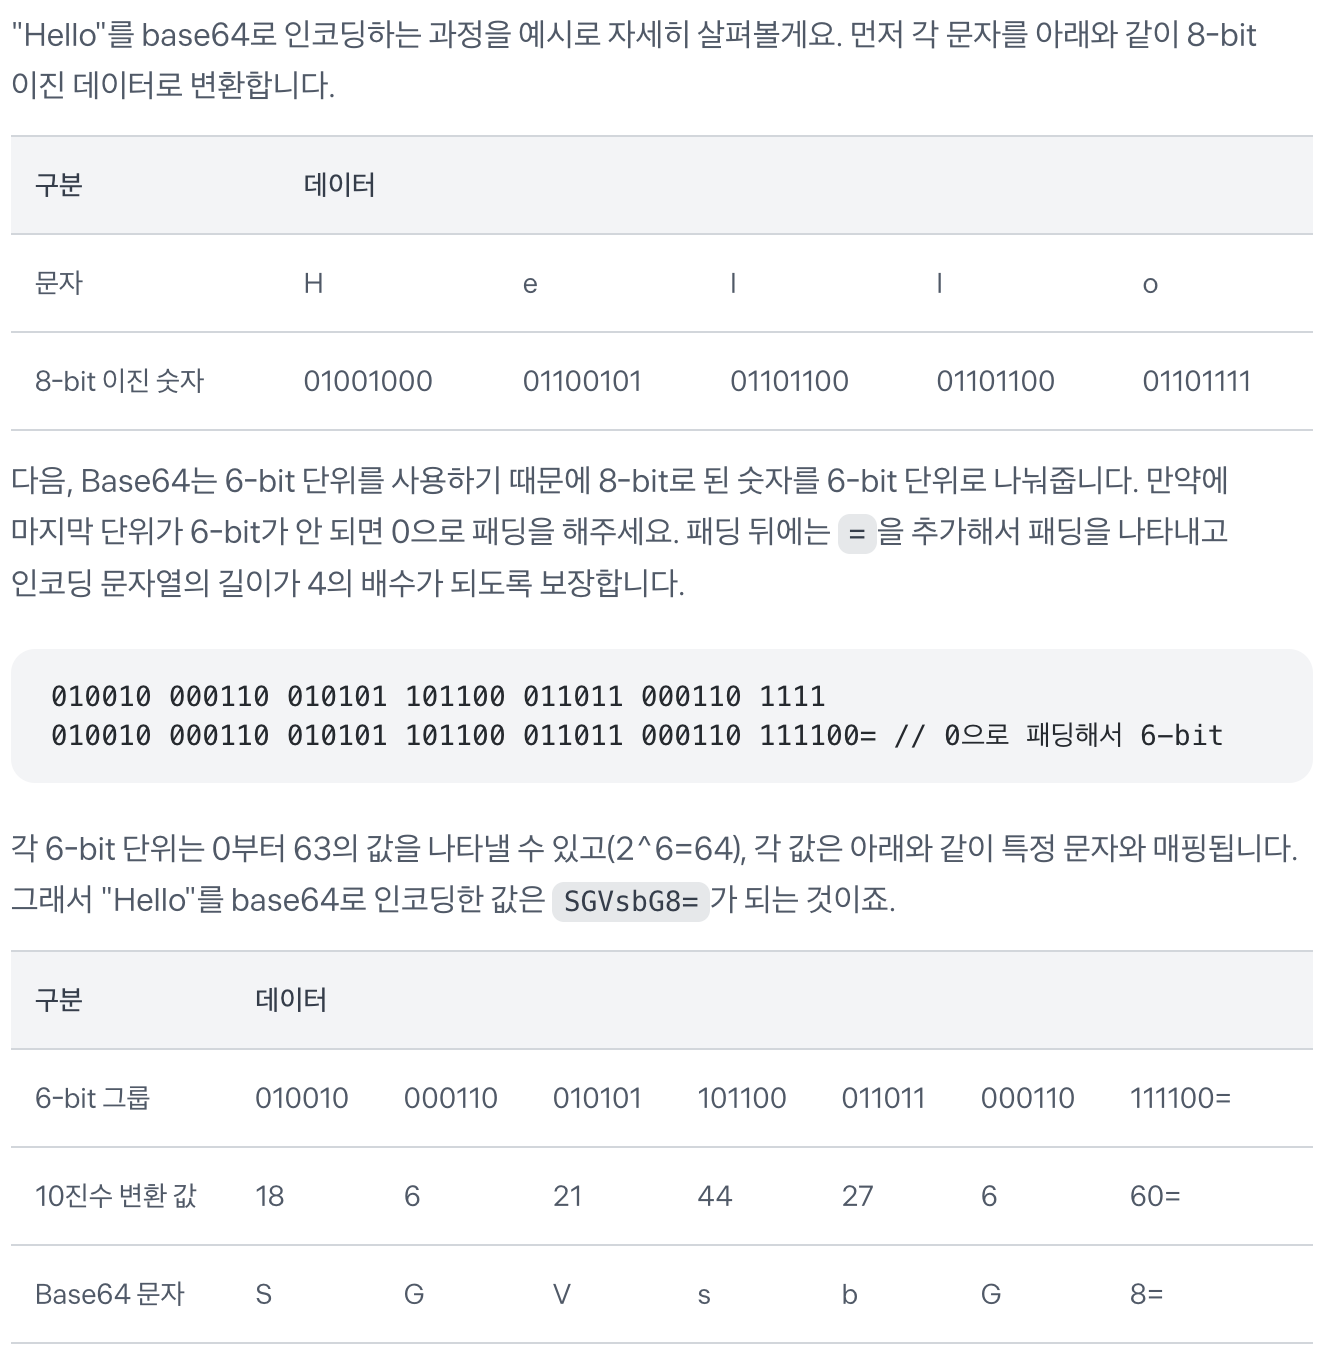
출처: https://docs.tosspayments.com/resources/glossary/base64
(4)
브라우저는 기본적으로 Base64 문자열을 디코딩하고 인코딩하기 위한 두 가지 JavaScript 함수를 제공합니다.
아래의 예시코드를 통해 인코딩/디코딩 과정을 쉽게 실험해볼 수 있다. 다만 함수의 이름 b(inary) to a(scii)에서도 알 수 있듯, 바이너리 데이터를 변환하는 것이 함수의 본래 의도로 탄생했기 때문에 ascii 범위를 넘어서는 유니코드 텍스트를 넘기면 오류가 발생한다. (해결하는 방식의 예시를 Mdn문서에서 제공하고 있지만 핵심은 아니므로 이 글에서는 패스…)
1
2
const encodedData = btoa("Hello, world"); // 문자열을 인코딩합니다.
const decodedData = atob(encodedData); // 문자열을 디코딩합니다.
Blob: 바이너리 이미지 데이터
(1)
Blob객체는 파일류의 불변하는 미가공 데이터를 나타냅니다. 텍스트와 이진 데이터의 형태로 읽을 수 있으며,ReadableStream으로 변환한 후 스트림 메서드를 사용해 데이터를 처리할 수도 있습니다.Blob은 JavaScript 네이티브 형태가 아닌 데이터도 표현할 수 있습니다.File이Blob에 기반한 인터페이스로, 사용자 시스템의 파일을 지원하기 위해Blob인터페이스를 상속해 기능을 확장한 것입니다.
Blob은 Binary Large OBject의 약자다. 불변하는 “미가공 데이터”란, 아직 특정 형식이나 구조로 해석/처리/인코딩조차 되지 않은 데이터의 가장 기본적인 원본 상태를 의미한다. 앞에서 보았던 base64와 같은 방식으로 인코딩하는 것처럼 어떠한 중간 과정도 거치지 않은 갓난 아기의 모습이다.
Base64는 텍스트 기반 환경에서 데이터 손상을 막으면서도 텍스트로 안전하게 변환하여 사용하기 위해 등장했었다. 그럼 Blob은 왜 필요했을까?
Blob은 이진 데이터를 ‘객체(Object)’로서 정의하며, 파일 시스템의 파일처럼 브라우저가 이진 데이터의 원본을 메모리 내에서 다룰 수 있게 하기 위해 캡슐화한 것이다.
객체라고 했으니, 주요 속성과 메서드를 살펴보자.
- 생성자 함수
Blob()
매개변수로 ArrayBuffer, ArrayBufferView, Blob, USVString로 이루어진 배열을 받아, 새로운 Blob객체를 반환
Blob.prototype.size는 Blob객체의 사이즈로, 바이트 기준이다.Blob.prototype.type는 데이터의 MIME 유형을 나타내는 문자열로, 알 수 없는 경우에는 빈 문자열이다.Blob.prototype.stream()Blob의 콘텐츠를 읽을 수 있는ReadableStream을 반환한다.
우리에게 익숙한 File 객체도 결국 Blob의 한 종류로, lastModified와 같은 새로운 속성도 있고 size, type처럼 Blob의 속성을 그대로 지닌다. 메서드를 따로 정의하지 않았지만, Blob의 메서드를 상속한다.
Object URL (createObjectURL): 메모리 상의 이미지 참조 VS Data URL: data:image/png;base64,... 형식
이제 Base64와 Blob을 모두 이해했으니 Object URL과 data:image/png;base64 형식 2가지를 모두 이해할 수 있다.
(1)
createObjectURL은 File, Blob 등의 객체를 받아 해당 객체의 참조 URL을 담은 DOMString을 반환한다. 이 메서드를 통해 생성된 ObjectURL은 브라우저 메모리에 저장된 특정 Blob객체를 ‘참조’할 수 있는 임시 주소인 것이다.
(이 예시를 통해 createObjectURL을 사용하여 이미지의 썸네일을 표시할 수 있다)
아래와 같은 형태를 갖는다. 이 URL이 요청되면, 메모리에서 해당 Blob 데이터를 직접 로드한다. 생성된 탭이나 창이 닫히면 자동으로 해제되나, 명시적으로 해제하기 위해서는 URL.revokeObjectURL을 사용할 수 있다.
"blob:https://cdpn.io/56249683-cee4-441c-b2d7-b93d3e91ccf5"
(2)
Data URL은 data:로 시작하는 형식을 통해 이미지와 같은 이진 데이터를 Base64로 인코딩하여 URL문자열 안에 직접 포함시키는 방식이다.
아래와 같은 형태를 갖는다. 브라우저는 이 문자열을 파싱하여 Base64부분을 디코딩하고 해당 결과를 이미지 데이터로 사용한다. 데이터 자체가 URL에 포함되어있기 때문에 이미지 로드를 위해 별도의 HTTP 요청이 요구되지 않는다.
data:image/png;base64,iVBORw0KGgoAAAANSUhEUgAA…
(3)
핵심 차이점은 url에 데이터 자체를 포함하는지, 또는 데이터를 참조할 수 있는 주소를 포함하는지다. 또한, 기본적으로 Base64 인코딩 방식은 표현할 때 문자열이 길어지므로(이진 데이터 바이트 3개 → Base64의 숫자 4개로 표현) Data URL로 표현할 경우 약 33%의 용량이 증가한다는 단점이 있다.
따라서 사용자가 선택한 용량이 큰 파일을 미리보기로 빠르게 보여주거나, 클라이언트 측에서 생성한 데이터를 다운로드 링크로 제공할 때는 Object URL이 유리할 것이다. 반면, 작은 아이콘이나 이미지를 사용하는 경우에는 Data URL이 간편하고 효율적일 수 있다.
🧐 Why?
- 데이터의 크기와 상관없이, 짧은 참조 문자열(DOMString)만 생성되므로
- 생성된 URL이 참조하는 Blob객체의 메모리 위치를 빠륵 ㅔ찾고 직접 로드하지만, Data URL은 긴 문자열을 파싱하여 Base64 데이터를 찾아내고, 이를 다시 디코딩하는 복잡한 과정을 거쳐야 하므로
Reference
- https://stackoverflow.com/questions/3538021/why-do-we-use-base64
- https://www.freecodecamp.org/news/what-is-base64-encoding/
- https://en.wikipedia.org/wiki/Binary-to-text_encoding
- https://docs.tosspayments.com/resources/glossary/base64
- [실습] https://www.base64decode.org/ko/